
2023年6月,OpenAI在GPT-4上推出了Function Calling:模型不仅能生成文本,还能输出一个结构化的函数调用请求,指定要调用的函数名和参数。
这意味着什么?在此之前,让LLM“做事情”是极其别扭的——你需要设计复杂的Prompt诱导模型输出特定格式的文本,然后用正则表达式去解析这个文本,稍有不慎就解析失败。
Function Calling让这件事变成了模型的原生能力:
{
  "tool_call": {
    "name": "get_weather",
    "arguments": {
      "city": "北京",
      "date": "2026-08-25"
    }
  }
}
模型不再“模拟”调用工具,而是真正输出一个可执行的调用指令。这就像给学者装上了一个标准的“手部接口”——从此以后,只要能连接到这个接口的工具,他都能用。随后,Claude、Gemini、Llama等主流模型都跟进提供了类似能力。工具调用的标准化,是Agent从理论走向工程实践的基石。
函数调用(Function Calling),也称为工具调用(Tool Calling),是现代大语言模型(LLM)的一项重要能力。它允许模型在对话过程中识别用户意图,并生成结构化的函数调用指令,从而与外部系统、API 或工具进行交互。
大语言模型虽然拥有丰富的知识,但存在以下局限性:
| 局限性 | 说明 | 函数调用的解决方案 |
|---|---|---|
| 知识时效性 | 训练数据有截止日期,无法获取实时信息 | 调用搜索引擎、新闻 API 等获取最新数据 |
| 计算能力 | 复杂数学计算可能出错 | 调用计算器、代码执行器等工具 |
| 数据访问 | 无法访问私有数据库或内部系统 | 调用数据库查询接口、内部 API |
| 执行能力 | 只能生成文本,无法执行实际操作 | 调用发送邮件、创建订单等执行类 API |
知识的局限性:大模型是在一个巨大的静态数据集上训练的。这意味着它们的知识是有限且过时的。它们不知道现在实时的天气、最新的新闻、某只股票的实时价格,或者你个人日历上的日程安排。
能力的局限性:大模型本质上是一个“文本生成器”。它能处理语言,但它无法执行实际的操作。它不能真的发送一封电子邮件、在数据库中查询数据、或者在你的设备上设置一个闹钟。
精确性的局限性:虽然大模型擅长生成连贯的文本,但对于需要精确、结构化数据的任务,比如查询一个地址,它们可能会出现幻觉(Hallucination),也就是编造信息。
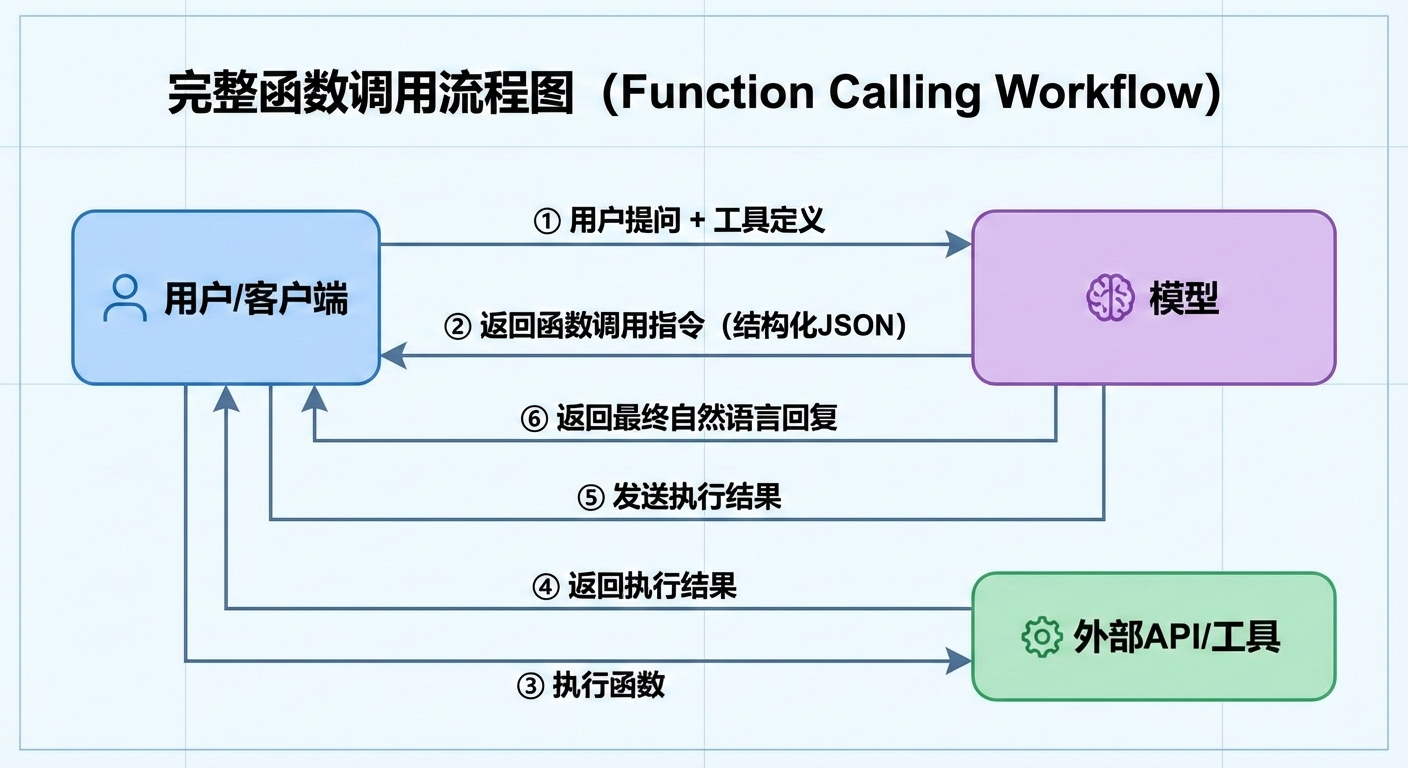
在最开始,你需要告诉大模型它有哪些“工具”可用。这就像你给一个助手一个工具箱,并告诉他每个工具的作用。
当用户提出一个请求(例如:“北京现在多少度?”),大模型接受请求后,会识别出它需要调用一个外部工具来获取信息。它的响应不会是常规的文本回复,而是一个结构化的函数调用参数。
这是整个流程中最关键的步骤。客户端在接收到大模型的响应之后,需要完成检查响应、解析指令、执行函数、调用实际的函数/API,获取结果。
这一步的核心任务是将执行结果发回模型,模型生成最终的自然语言回复。大模型接收到所有这些信息后,会利用函数执行的结果,生成一个自然流畅的最终回复给用户:“背景现在晴朗,气温是34°C。”
评论专区
评论加载中...登录后即可发表评论