最朴素的 RNN 是这样的:
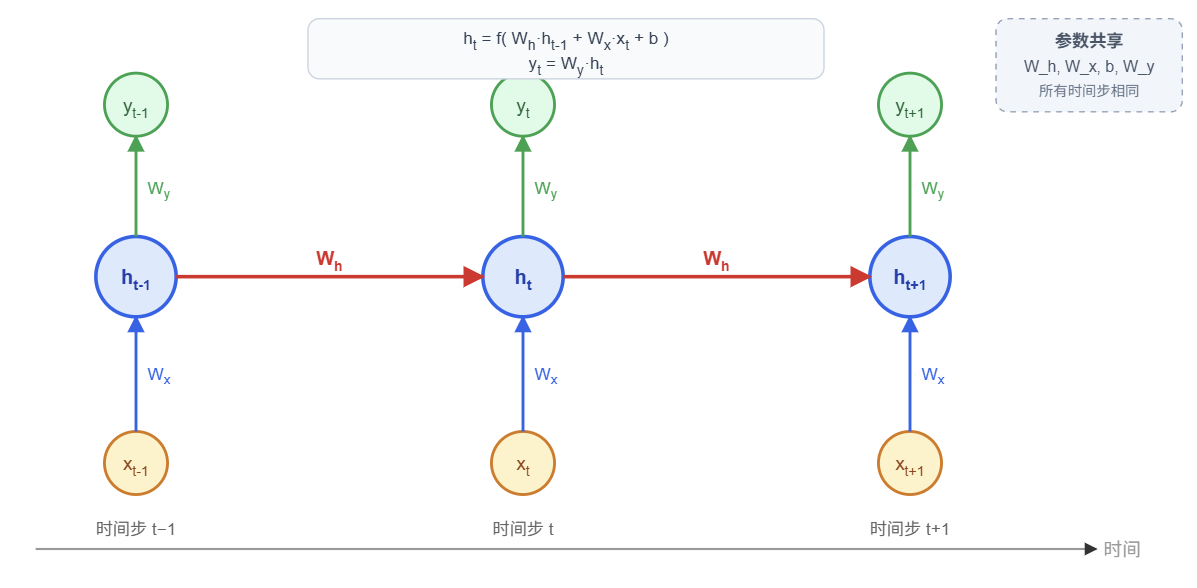
$$
h_t = f(W_h \cdot h_{t-1} + W_x \cdot x_t + b)
$$
$$
y_t = W_y \cdot h_t
$$
关键点:
- $W_h$、$W_x$、$b$、$W_y$ 在所有时间步是同一套参数。备注:$W_h$表示隐藏层到隐藏层的权重;$W_x$表示输入到隐藏层的权重;$W_y$表示隐藏层到输出层的权重
- 不是每个时间步有一套独立参数。
- 这就是所谓的“时间不变性”或“参数共享”。
为什么这样设计呢?请看下文的分析。
1、序列任务的本质:同一套规律在不同时间重复出现
语言、语音、时间序列都有一个特点:
- “主语后面跟谓语”这个规律,在句子开头成立,在句子中间也成立。
- “过去几帧预测下一帧”这个规律,在序列早期成立,在后期也成立。
- 规律本身不随时间变化。
如果每个时间步用一套独立参数:
- 模型要为每个位置单独学规律。
- 数据被切碎,每个位置样本少,学不好。
- 参数量随序列长度增长,无法处理变长序列。
所以共享参数的本质是:假设“时间步之间规律相同”。
2、类比 CNN 的平移不变性
CNN 假设:
- 同一个模式出现在图像不同位置,应该被同样识别。
- 所以卷积核在空间上共享参数。
RNN 假设:
- 同一个模式出现在序列不同时间,应该被同样处理。
- 所以循环权重在时间上共享参数。
两者是同一个思想,只是一个在空间维度,一个在时间维度。
3、参数共享带来的好处
(1)参数量与序列长度无关
- 不管序列多长,参数量固定。
- 可以处理任意长度序列。
- 这是 RNN 能用于变长序列的关键。
(2)样本效率高
- 同一套参数在所有时间步被反复训练。
- 每个时间步的数据都在更新同一套参数。
- 相当于数据被复用,学得更充分。
(3)泛化到没见过的长度
- 训练时见过长度 10,推理时长度 20 也能用。
- 因为参数不依赖具体位置。
- 这是“时间不变性”的直接收益。
(4)符合序列规律
- 语言、语音、时间序列的规律通常不随时间变化。
- 共享参数是对这个事实的合理假设。
- 这是一种归纳偏置:假设时间平移不变。
4、时间不变性的代价
共享参数不是没有代价:
- 假设太强:如果序列规律随时间变化,共享参数就不合适。
- 位置信息弱:RNN 不像 Transformer 那样显式建模位置,靠顺序计算隐式表达。
- 长距离依赖难:同一套参数反复乘,梯度容易消失或爆炸。
- 难以并行:因为 $h_t$ 依赖 $h_{t-1}$,必须串行。
所以时间不变性既是 RNN 的优点,也是它的限制。
5、和 Transformer 的对比
- RNN:强假设“时间不变”,参数在时间上共享。
- Transformer:弱假设,参数不随位置共享,位置靠位置编码注入。
- 数据少时,RNN 的强假设有帮助。
- 数据多时,Transformer 的弱假设更灵活。
6、一句话总结
RNN 假设时间不变性,是因为序列任务的规律通常不随时间变化,同一套规律在不同时间步重复出现。共享参数让参数量与序列长度无关、样本效率高、能泛化到未见长度,这本质上和 CNN 的平移不变性是同一个思想。代价是假设较强、位置信息弱、长距离依赖难、无法并行。

评论专区
评论加载中...登录后即可发表评论